



没换模型,token 少了一半:NVIDIA SoL-Pi 动的那层你天天在用

过去一年,想把 Agent 的账单压下去,来来回回就那几招:换便宜点的模型、等厂商降价、把 prompt 再抠一遍。抠完再看账单,确实降了,降得不多,而且过阵子又爬回去。
最近有一条反着走的路子摆到台面上:不换模型,不微调,不重训,token 流量掉下去接近一半。出处是 arXiv:2609.20519,2026 年 9 月 17 日提交,15 页,14 位作者,NVIDIA 联合 NTU 和 MIT 一起做的,代码以 MIT 协议开在 github.com/NVlabs/SoL-Pi。
这篇让我挪不开眼的不是省了多少,是它把刀口换了个方向。
烧钱的不是模型,是模型和环境中间那一层。
泼盆冷水:省钱的方向一直是错的
降本这件事,行业默认的发力点是模型本体。更快的 kernel、更狠的量化、更小的模型,每一轮都在同一个地方使劲。换便宜模型这条路短期确实有用,代价也清楚,能力一起打折,站内聊过的 Jev 就是走的专用模型这条路。
NVIDIA 这组人的做法是把目标从模型本体挪开,去看模型和外部世界之间的那段流程:任务怎么递给模型,工具产出怎么回到模型眼前,上下文怎么留着、怎么扔掉。
这一层过去几乎没人认真称过重量。称完的结果有点扎心:里面藏着接近一半的 token。
harness 到底是什么:发动机外面的那套标定
打个比方。模型是发动机,参数量决定马力上限。harness 是变速箱、油路和油门标定,决定你踩下去的那份油,有多少真的传到轮子上,有多少在传动途中变成了热量。
让 Agent 修一个 bug,它会先翻三个文件,跑一遍测试,看报错,再改一次。”读、跑、看、再改”的先后顺序,每次结果带回来多少字节,哪些内容留在窗口里,全是 harness 定的。
发动机不动,标定改一改,油钱能差出一倍。这就是 SoL-Pi 要啃的地方。站内之前写 DeepSeek Harness 时提过这一层的重要性,这次是有人把它量化成账单了。
让 AI 盯着 AI 干活:152 个方向是怎么筛出来的
论文全名叫 Recursively Scaling Auto-Research Loops for Efficient Agent Harness,做法倒比名字朴素:一个研究 Agent 盯着另一个 Agent 的完整执行轨迹看,从里面提出 harness 层的改法,自己搭起可执行环境去验证,跑通了留下,跑不通丢掉。
规模堆得很凶:535 个可执行环境,152 个探索方向,3000 多次运行,6 万次以上的 agent 与环境交互。任务来源也不糊弄,495 个来自配好对的 GitHub issue 和 PR,外加 40 个合成测试。
为了防止自己骗自己,他们把 EdgeBench 那 51 个公开任务整个隔离在搜索之外:抽 11 个做一次性验证,剩下 40 个锁死,只留给最终评测,成绩绝不回灌到搜索里。
还有一个更硬的旁证。用 GPT-5.6 Sol 搜出来的这套 harness,原封不动搬到 Opus 5 上,仍保留 94.3% 的 Pi 表现,节省幅度相当。这说明搜出来的东西不是过拟合在某颗模型上的巧合。让一条轨迹被另一双眼睛反复剖析,这套路和站内聊过的 Codex 多智能体 算是近亲,目标从多干点活换成了少花点钱。
四个机制,各自专治一种浪费
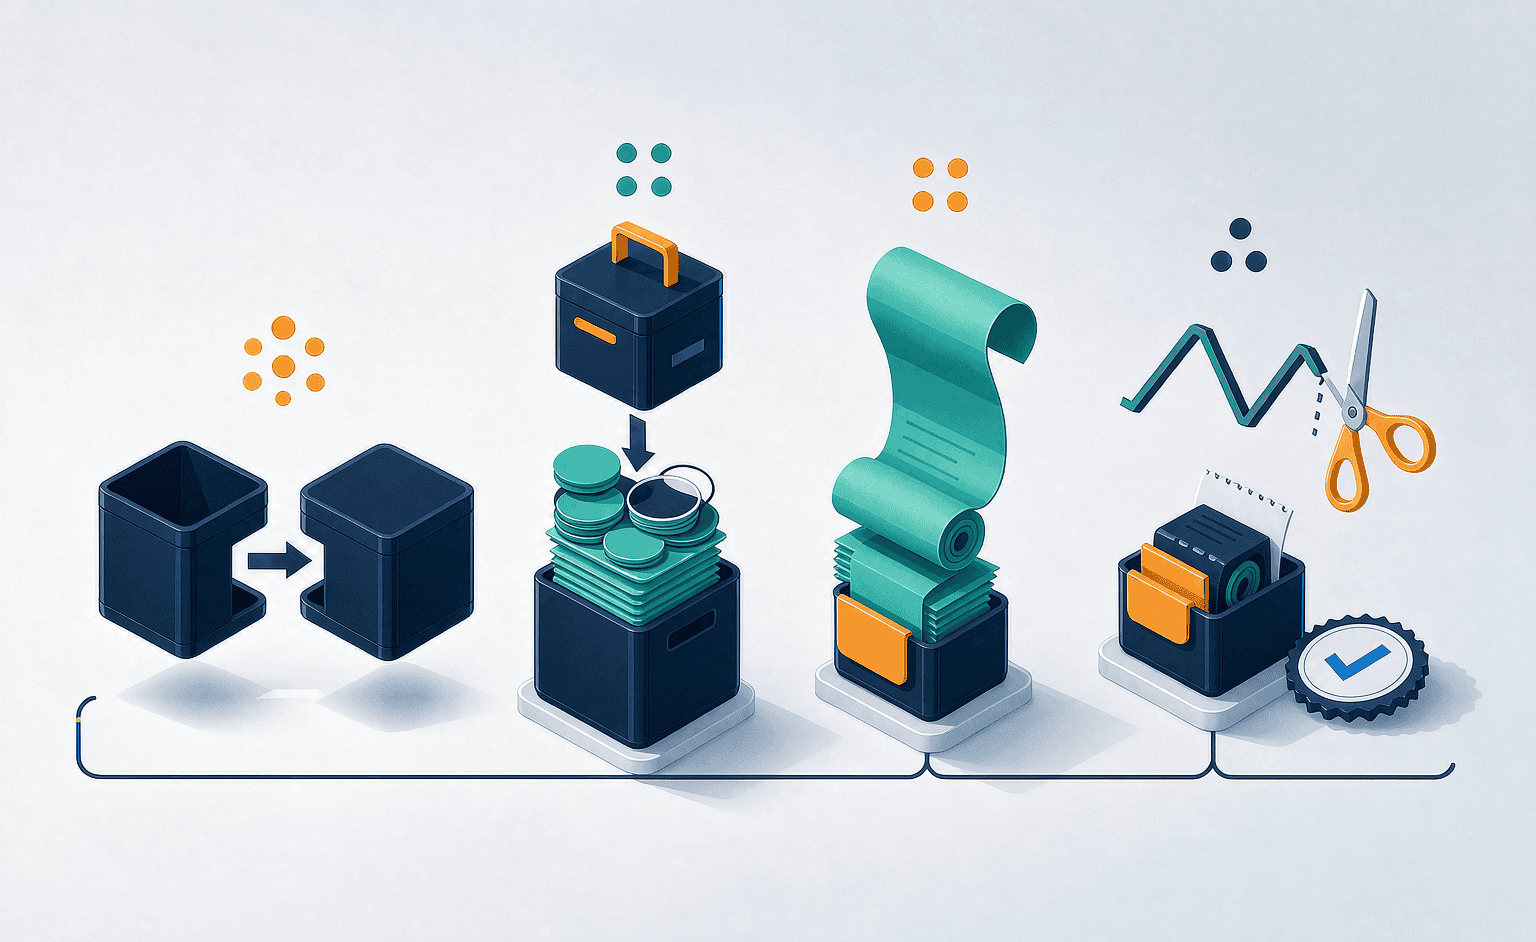
最后留下四个,全部默认关闭,要显式 opt-in,并且都不去 patch Pi 的源码。它们各打一种具体的浪费。
Action Fusion:同一趟里顺手把活干完
编辑完了通常要跟一条校验命令,命令的结果又要送回模型那儿等下一步。这个机制允许在同一次工具调用里把后续校验带上,改完就跑测试,合成一步。它治的浪费叫空跑的那一趟:结果已经能拿到,却偏要再付一次往返。
ObservationPack:同一块内容只收一次钱
反复出现的大段文本,比如同一个文件被 dump 三次,会被换成稳定句柄,需要时按页精确召回。它治的浪费叫重复付费:同一份材料,模型按份买了三遍。
Evidence-Preserving Reducer:压对了才算数
长长的诊断日志交给便宜模型压成一张回执,省下主模型的输入。但验收卡得很死:压完之后,留下的每一句引用都必须能和归档原文逐字对上,对不上就作废,原始结果原样保留。它治的浪费叫为了省钱丢掉证据,而这一层丢证据的代价,比 token 贵得多。
Online Context Compact:够条件才压,到点不压
已完成的计划步骤要成为压缩候选,得同时过两道检查:这一步完成得是否经济,以及窗口压力是否真的到了。它治的浪费叫过早地扔东西。
四条共用规矩也值得记一下:不 patch Pi,必须显式 opt-in,压缩失败不改原文且本地仍可取,认证、provider、主模型和 shell 行为依旧归 Pi 管。

上手:一行命令,先开两个
SoL-Pi 是挂在开源 Pi 编码 Agent 上的独立扩展。README 里写着前置条件是 Node.js 22.19 或更新、npm、以及 @earendil-works/pi-coding-agent 0.85.1。
# 装 Pi 本体,版本卡死在 0.85.1
npm install --global @earendil-works/pi-coding-agent@0.85.1

# 装上 SoL-Pi,它作为独立扩展挂进 Pi
pi install git:github.com/NVlabs/SoL-Pi

# 只想让当前项目生效
pi install git:github.com/NVlabs/SoL-Pi --local --approve
有几个坑 README 里都不显眼。配置文件先找项目级的 .pi/sol-pi.json,而且要求该项目被标为受信任;找不到才去看全局的 ~/.pi/agent/sol-pi.json。两个文件不做合并,都没有就用内置默认值。改了全局配置却一直在等它生效,多半是项目里那个文件优先级更高。
先别贪多,从这份保守配置开始:
{
  "version": 1,
  "actionFusion": true,
  "observationPack": true,
  "evidencePreservingReducer": false,
  "onlineContextCompact": false,
  "cacheWriteReadRatio": 12.5
}
这两个本地机制不做额外模型调用,也不会中断正在跑的任务。
如果你是个人开发者,先只开上面这两个,跑几天看账单曲线。如果你在管团队成本,再把另外两个打开,并且照着对齐自己业务的评测跑一遍再定,别直接照搬 EdgeBench 的百分比。如果你本来就给着 128K 以上的大窗口,先把预期往下压一档,原因在下一节。
开发者自检这条链路 README 里给得很完整:npm ci --ignore-scripts,然后 npm run check,再 npm audit --audit-level=high,最后 node scripts/check-pi-compat.mjs。全开配置的校验脚本是 scripts/check-sol-pi-config.mjs --require-all-enabled。
这些数字该怎么读:看趋势,别当排行榜
评测在 EdgeBench 的 51 个任务上跑,用 GPT-5.6 Sol 和 Opus 5 两颗前沿模型。
- 效率版(四个机制全开):token 少 49%,达到 Pi 分数的 93.7%。
- 性能版(只挑最强单机制):分数反超 Pi 5.3%,同时还在省 token。
- 整体 token 降幅 44.7% 到 49.0%,API 成本降约三分之一。
- 相比原生 Codex 和 Claude Code harness,便宜 50% 与 54.3%。
- 折成现金:对比原生 harness,一小时省 8.75 到 13.50 美元;对比 Pi 基线,一小时省 4.36 到 5.71 美元。一次完整测试的总成本从 1339 美元降到 894 美元。
得补一句:以上全部是厂商自己公布的跑分,目前还没有第三方复现。看趋势,别当排行榜。
别踩这三个坑:它不是万能的
论文里最诚实的部分是消融实验。上下文窗口从 32K 加到 128K,harness 带来的增益从 35.7 点衰减到 2.7 点。换句话说它的价值建立在上下文吃紧这个前提上,你给的空间越宽,这套省法越没必要。
第二个坑更隐蔽。更短的上下文会削弱 prompt cache 的复用,缓存命中率掉下去那部分,要从省下来的钱里扣。省 token 不等于省一切。
第三个坑是换个基准就露怯。Terminal-Bench 4 的 63 个 CPU 任务里,SoL-Pi 解出 15 个,Codex 和 Pi 各解出 18 个,只是总成本比 Pi 低约四分之一。
另外两处边角料也记一下:Lean 4 的 2026 奥数题六道解出三道,单题解出成本最低;kernel 优化测试中,20 个 SoL-Pi worker 比同等规模的 Pi swarm 省 26.8% 成本。
写在最后
过去所有人都在给发动机减重,SoL-Pi 第一次把秤挪到了传动系统上,称完发现大头在这儿。
更有意思的是它的运作方式:不用人去猜哪层该瘦,让一个 Agent 盯着另一个 Agent 的轨迹,自动提提案、自动验证、通过就留。这是给 Agent 做编排的思路,第一次被用在了成本曲线上。
回头看开头那笔账,抠模型、抠 prompt,抠的都是看得见的地方;真正吃掉一半 token 的那一层,平时连名字都想不起来。
觉得有用的话,点个赞,顺手转给那个天天盯着预算表的同事。关注圈圈,第一时间看到新的 Agent 玩法。













暂无评论内容