



闭嘴,只做选择题:Jev 上手指南
三百字提示词换一个 JSON:这活儿真的不该这么干
为了让大模型只回一个 JSON,你写过三百字提示词。开头声明身份,中间列规则,结尾补上一句 只输出 JSON,不要解释。它乖了三次,第四次给你来一句 好的,以下是分类结果:,后面还挂了个 Markdown 代码块。
于是你又写正则去剥代码块,写兜底去补半截 JSON,写重试去赌下一次。
问题根本不在提示词写得好不好。问题在于,你租来的是 System 2,一个会写长文、会推理、会解释自己的大脑,干的却是 System 1 的活:分桶、打分、判断是与不是。这买卖从第一句话开始就亏了。
Jev 反过来干。它一个字都不生成,只给你一个定型答案,外加一个校准过的概率。

先搞清楚一件事:Jev 和你用过的 AI 根本不是一类东西
卡尼曼把人的思考分成两套。System 1 快、自动、不费力,看一眼就知道这是张生气的脸。System 2 慢、要专注、会算,让你在心里做 17 乘 24。今天的大模型天生是 System 2,一个 token 一个 token 往外吐,吐完了才算给完答案。
TypeSafe AI 把 Jev 这类模型叫 System One,名字就是从这儿来的。2026 年 9 月 15 日发布,同一天官宣 4000 万美元融资,DCVC 领投。官方与多家媒体介绍创始人 Diogo Almeida 曾在 OpenAI 参与 RLHF 与 InstructGPT,这是介绍方的说法,不是他自己挂出来的功劳牌,读的时候留个心眼。
那它到底快在哪、省在哪?端到端延迟 70 到 500 毫秒。定价是输入 0.042 美元每百万 token,输出免费。对,输出免费,因为它压根没有输出。
厂商自己跑的数:在自家 workflow evaluations(evals.typesafe.ai,4 个任务、711 个用例)上,最高 193.6 倍快、444.6 倍便宜。同等成本下跑 MMLU-Pro,Jev 拿 82.9%,跑在 Qwen3.6-35B-A3B 上的 Jev 兼容 API 是 58.8%。这两组数都是 TypeSafe 自己跑的,目前没有第三方复现,别当成客观评测结论往下传。
只有三种原语:Choice、Score、Noul 怎么用
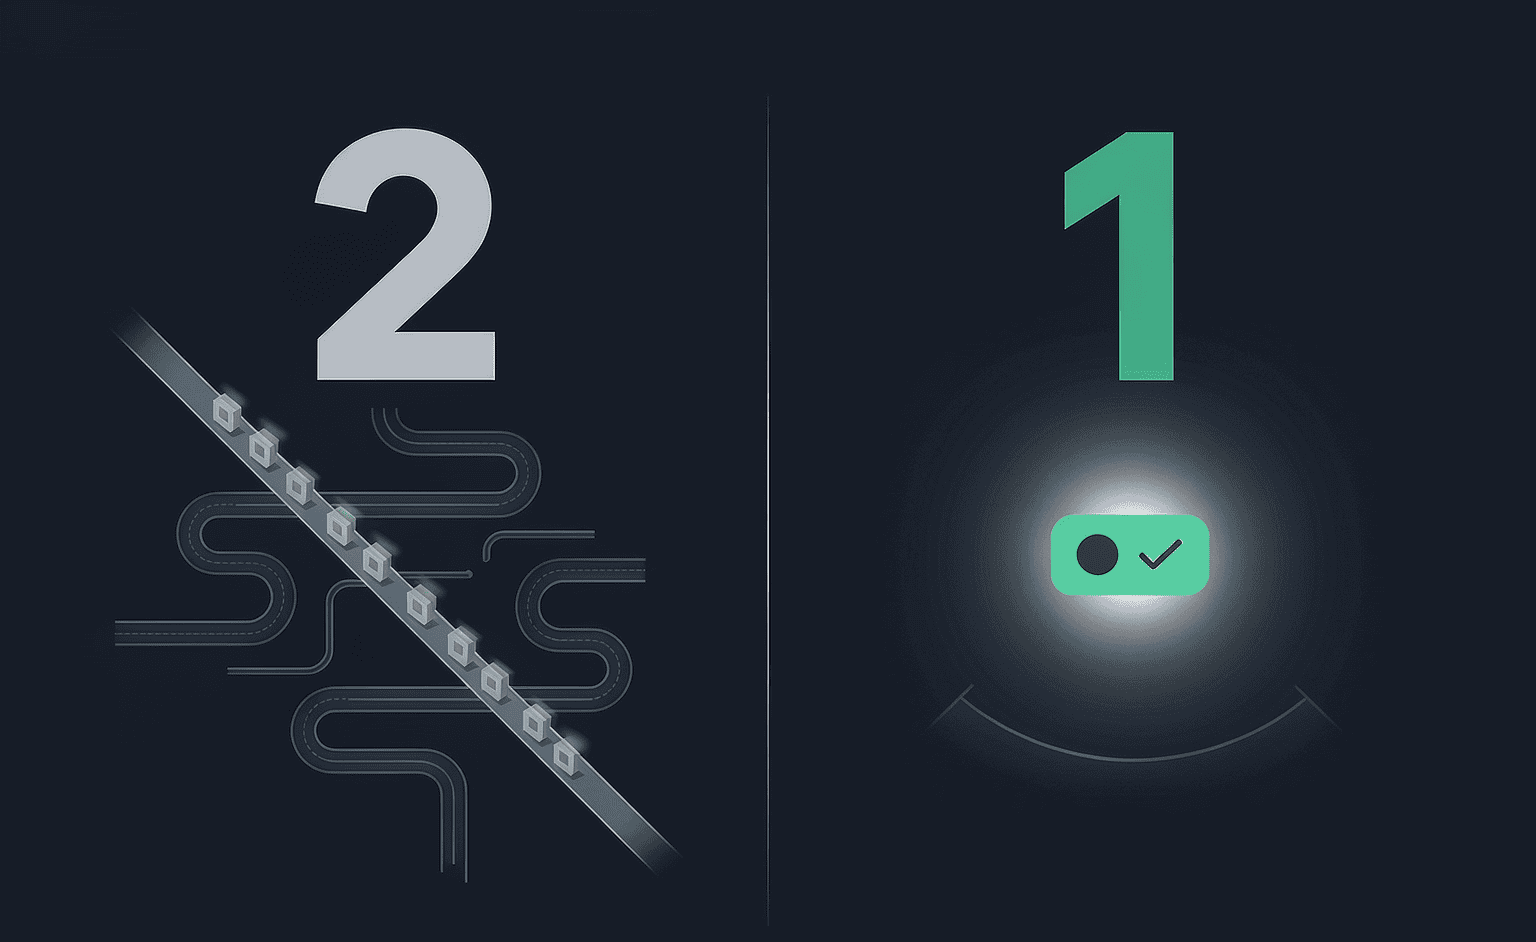
结论先说:Jev 的 API 只有三种问法。这叫设计,不叫限制。
一次调用里,你给它一个 state(程序状态,字符串、对象、数组都行),再加一组类型化问题,全部并行算完,直接返回定型答案。上面那张图里填选项的活,就是这么干的。
Choice:从一组选项里选一个
最多 255 个选项,返回 .choice、.probabilities、.confidence。官方有两条建议,非常关键:把完整的团队列表或分类列表全传进去,别自己先裁一个短名单;另外一定要留一个 other 选项,让模型能说 都不合适,而不是硬挑一个看起来最近的错答案。
Score:2 到 10 个有序档位
档位用文字描述,别写 1 到 5。返回的 .score 可以落在两个档位之间,不是整数。档位序号来自数组顺序,第 0 项是你写的第一条。
Noul:是或否
返回一个 0 到 1 的概率,没有 confidence 字段。为什么没有?因为这个数本身就是信念,再包一层置信度没意义。
工单分诊实战:一次调用把分类、紧急度和要不要升级全问完
过去你要三次调用加三次解析。现在一次。
安装就一行命令,pip install typesafe-sdk。SDK 从环境变量读 TYPESAFE_API_KEY,默认模型 jev-latest。
from typesafe import SystemOne
client = SystemOne()  # 读 TYPESAFE_API_KEY,默认 jev-latest

TEAMS = ["billing", "technical", "account", "onboarding", "other"]
LEVELS = ["这周内处理就行", "两三天给答复", "今天必须回复", "立刻停活"]

def triage(ticket: dict) -> dict:
    res = client.evaluate(
        state={"subject": ticket["subject"], "body": ticket["body"],
               "plan": ticket["plan"], "open_tickets": ticket["open_tickets"]},
        questions={
            "team": {"type": "choice", "options": TEAMS},
            "urgency": {"type": "score", "levels": LEVELS},
            "needs_escalation": {"type": "noul"},
        },
    )
    return {"team": res.team.choice, "confidence": res.team.confidence,
"urgency": res.urgency.score, "escalate": res.needs_escalation.probability}两处要注意。urgency 用文字档位而不是数字刻度,模型才知道 4 分到底有多急。TEAMS 末尾留了 other,这是官方明确要求的兜底,别省。
换个问题组,同一份 state 就是另一套玩法:agent loop 里选下一个工具或子 agent,行动之前给风险打分,检索前先过滤一遍候选。工具路由这块,如果你已经在上 MCP,可以配着 MCP 协议那套工具描述规范 一起看,MCP 负责提供 能选什么,Jev 负责 选哪个。
再看一组非厂商的数据。社区独立测试拿 32 类销售电话录音做打标任务(含 20 个对抗样本),Jev 得 35/36,生产环境用的小分类器 34/36,单次调用成本约百分之一,三次运行没有标签漂移。社区复刻版 OpenJev(DiffusionGemma 加单步去噪)约 170 毫秒延迟,198/201 准确率。
置信度才是方向盘:阈值怎么设,中间带为什么交给人
置信度在读 result.providerMetadata.typesafe.confidence,只有 Choice 和 Score 有,数值保留两位小数。走 Vercel AI Gateway 的话,模型 ID 是 typesafe-ai/jev,通过 AI SDK 7 的 experimental_evaluate 调用。
const result = await evaluate({
  model: 'typesafe-ai/jev',
  state: { subject, body, plan },
  questions: {
    team: { type: 'choice', options: TEAMS },
    urgency: { type: 'score', levels: LEVELS },
  },
});

const conf = result.providerMetadata?.typesafe?.confidence;

if (conf >= 0.85 && result.team.choice !== 'other') await route(result.team.choice);
else if (conf >= 0.6) await askHuman(result);
else await fallbackToLLM(result);
为什么必须留个中间带?因为 confidence 落在 0.6 到 0.85 之间的那些样本,恰恰是人看一眼就能定、模型却犹豫的地方。全自动会把这批全做错,全人工又白买了速度。把中间带交给人,是这套东西唯一正确的用法。
顺带说一句,继续、重试、问用户还是停下,这个判断本身就是 agent loop 里最花钱的决策点。回头看看 OpenAI Agents API 里那些循环控制,你会发现原来这一步是要让大模型先写一段推理的。现在不用了,一个 noul 就够。
零幻觉的边界:它保证什么,不保证什么,得说清楚
官网写着 Zero Hallucinations。但官方发布说明自己补了一句:Our number is not empirical. Schema matching is guaranteed.
翻成人话:你问 billing、technical、account、other 四个选项,它保证返回这四个之一。不会给你带个句号的 Billing.,也不会现场发明第五个团队。仅此而已。
它照样可能选错。The Register 的评价是这个 无幻觉 对比不公平,因为它的输出根本不是自然语言,没有可比性。开发者 Anthony Maio 也指出,schema 保证挡住的只是格式错误,挡不住选错选项。训练方法官方称 RLCD。

坑 1:把 无幻觉 理解成 不会错
现象:接进自动路由之后,错误率没降,只是错误变整齐了。根因:schema 保证的是输出形状,不是判断正确性。解法:把 confidence 阈值接进流程,低置信度和 other 一律转人工。
坑 2:拿它做细粒度的语义评分
现象:有开发者实测,用它给软件规格质量打分表现太弱,明显不如 Gemini Flash 3.8。根因:判断粒度和语义复杂度上去的地方,它撑不住。解法:这种活还是交给会说话的模型,别硬上。
坑 3:直连的 API key 还在排队
现象:直连端点是 POST https://api.typesafe.ai/v1/systemone,但 key 目前还在 waitlist 里。根因:产能没放开。解法:想立刻用,走 Vercel AI Gateway,9 月 16 日就上线了。
拿它校验别的模型输出、做护栏这一步,怎么接进现有链路,可以配 LangSmith 的那套评测与追踪 一起看,前者给判断,后者留证据。
写在最后:让会写字的去写字,让会判断的去判断
说白了,过去两年我们一直在干一件别扭的事:拿一个会写小说的脑子,去填快递单。
Jev 不是更强的模型,它是更窄的模型。它放弃的恰恰是大模型最贵的那部分能力:说话。换回来的是 70 到 500 毫秒、输出免费、还有一个敢直接拿来做 if 判断的概率。
回到开头那三百字提示词。它真正的问题不是写得太长,而是你根本不该让模型开口。
下次要做的如果是 这属于哪一类、要不要升级、风险几分,先问自己一句:我需要它说话吗?不需要,就别租 System 2。
关注圈圈,持续带你玩转 AI 工具。
















暂无评论内容