




视频还在播你就能改它:Vidu S2 全量开放,实时流上手指南

看腻了发布会?这次它动的不是成片,是正在播的那条流
这两年你大概已经免疫了。每隔几天就冒出一个视频大模型,画面更漂亮,样片更惊艳,然后你点进去,流程还是那一套:写提示词,点生成,盯进度条,拿到一段成片。不满意就改提示词,再等一遍。
这个循环的本质是内容是死的,你只能重做。就连 阿里 Wan3.0 直接把 PPT 生成 30 秒成片 这种提效狠活,解决的也只是更快出一段,出完之后想改,还是得回到起点。
所以 9 月 16 日生数科技发布 Vidu S2,我的第一反应不是又来一个,是真愣了一下。它换了个问题在解。过去两年所有模型都在琢磨怎么给你生成一段更好的视频,Vidu S2 琢磨的是另一件事:视频还在播,你怎么随时改它。
而且不用排队。发布当天就全量开放,vidu.com/vidu-stream 直接能上手,API 文档同步放出,GitHub 仓库 shengshu-ai/Vidu-S 也公开了。距上一代 S1 发布,只隔了 69 天。
先说清楚看哪一段,你才好决定这半小时花在哪:
- 做电商、做直播的,直奔第三章,实时换装和换背景是你最该看的。
- 关心数字人、虚拟陪伴、AI 主播的,第四章是重点。
- 想搞懂流式视频为什么一过几分钟就崩的,第五章别跳,那才是真东西。
两个模型,一个管人,一个管画面
先泼盆冷水。Vidu S2 不是一个模型,是两个,各管一摊,混着看你一定会看晕。
S2-Avatar 管人,做的是持续交互的数字角色。你可以把它想成一个永远不下播的主播:镜头一直开着,你说一句它动一下,中间不黑屏、不重启。上一代基本是个说话的头,这一代连跳舞这种大幅肢体动作都跟得上。
S2-Editing 管画面。它接的是一条正在流动的视频流,实时改风格、改衣服(虚拟试穿)、换人物、换背景。它更像给直播信号接了台实时调色台,推子在你手里,画面还在往前走。
你要的是让人一直活着,还是要让画面一直变,选的模型完全不一样。

直播还在跑,衣服和背景当场换掉
先说最容易变现的那个,S2-Editing。
思路上你得先转个弯,别拿它当剪辑软件。剪辑软件是先拍完再改,它是边播边改。所以正确用法是:把一场直播或者一条短视频,当成可以中途改主意的东西。
提示词怎么写?我的建议是,给保留下的指令要比给改变下的更具体。因为帧对齐稀疏注意力干的活儿就是让改动贴合原来的运动轨迹、不穿帮,你把要保的东西说清楚,它才不会顺手把你的人物也一起改了。
换装:保留模特的走位和手势,上身换成米白色亚麻西装,
袖口保留褶皱细节,光照跟随原场景主光源

换背景:人物与运动轨迹完全保留,背景切换为暖色木质直播间,
地面反射随人物移动变化
电商这边最直接的用法是虚拟试穿。以前一个 SKU 要拍一遍,现在是一条流里连续换。做短视频的则可以一条素材跑多个版本,同一套人物动作,换三件衣服、三个背景,出三条内容。
我不给你编点这里点那里的路径,界面会变。但有件事确定:先拿你自己的真实素材去试,别拿官方样片的标准衡量你手里那条抖得厉害的手机素材。
数字人终于不掉线了:720P 和随时插参考图
再看 S2-Avatar。
分辨率从 S1 的 540P 提到 720P,帧率 25 到 42 FPS。540P 在手机竖屏里还能糊弄,一上大屏就露馅,720P 算是摸到了能进直播间的门槛。
但真正让我觉得有意思的是动态参考图。以前做数字人,你想让它换件衣服,得停掉会话、重传参考图、再起一遍,观众那头看到的就是一次卡顿或者说重来。现在可以在流不中断的情况下追加新的参考图,服装、道具、场景当场换,会话不重启。
说到参考图,站内之前聊过 Seedance 2.5 用 50 张参考图锁死人物,那套思路是开工前把一致性备足。Vidu S2 走的是另一条,参考图可以在流跑起来之后再加,靠的是状态保留,角色能持续响应新指令和新视觉信息。一个是开工前备料,一个是开工后加料,适用场景不一样。
所以数字人直播、AI 陪伴这类长时交互场景,这次是真进了一步。它第一次让中途改主意不必付出掉线的代价。
流式视频为什么一过几分钟就崩
这一段是硬货,但你听懂了,就知道这 69 天到底卷在哪。
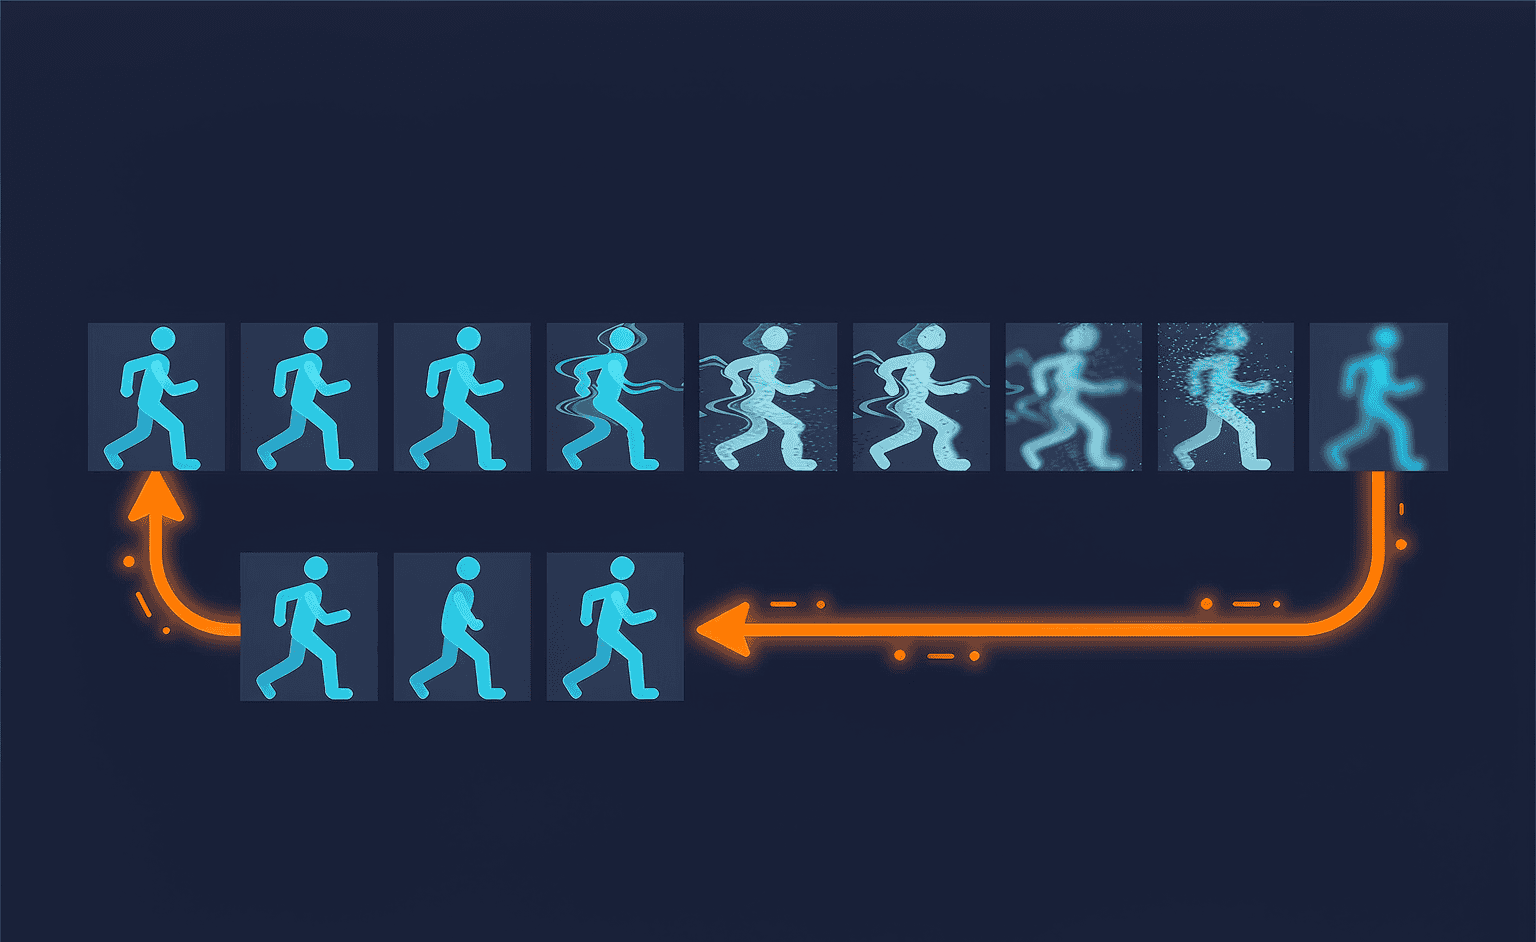
流式视频生成有个老毛病,叫误差累积。每一段都以上一段自己的输出为条件,前一帧歪一点点,后一帧跟着歪,几十秒之后角色就开始融化、漂移、崩坏。特别像传话游戏,传到第十个人嘴里,那句话跟第一句已经没关系了。
SRF(Self-Replay Forcing,自回放强制)就是治这个的。做法朴素得有点可爱:把模型自己生成的轨迹重新加噪,再回放给它自己看一遍,走一条可以算梯度的因果前向路径。等于让它反复练习接住自己刚才那一拍,而不是一直以为自己在跟标准答案走。训练时就喂自己的输出,推理时再撞见自己的输出,它才不会飘。
留意用词,官方说的是抑制漂移和崩坏。抑制这两个字,跟根治之间差着好几个数量级的工程量。
第二个主角是推理栈,也是这次最容易被漏掉的部分。720P、25 到 42 FPS 这个数字,不是模型本体一个人撑起来的。GitHub 上写得很明白:TurboDiffusion 加 TurboServe 的服务栈,堆了高效注意力、低比特 GEMM、kernel 与启动优化、多 GPU 流水线,目标就是把实时推理压到低成本 GPU 上。模型决定上限,推理栈决定这个上限你买不买得起。
如果你一直在看这波视频模型,会发现大家卷的是先出成片,比如 MiniMax H3 一张图加一句文案自动出成片,本质还是离线渲染。Vidu S2 把力气花在延迟和长时稳定上,这是两条不一样的赛道,别拿同一把尺子量。
补个背景。这套东西的全链路研发由清华朱军教授的博士生、生数科技流式视频生成与推理负责人张金涛负责。生数科技由清华大学计算机系教授、IEEE Fellow 朱军领衔创立,2024 年发布过中国首个长时长、高一致性、高动态性视频大模型,走 U-ViT 融合架构。
先别急着吹,这几个坑我得说清楚
坑 1:成绩全是官方自报,第三方复现还没跟上
现象:S2-Avatar 在 StreamAV-Bench 九项指标上拿到报告所列对比模型最优,S2-Editing 在多项视频编辑基准上总分超过报告所列的离线与流式模型。根因:技术报告 9 月 10 日上传 arXiv(2609.11638),9 月 15 日以 393 赞登上 Hugging Face Daily Papers 第一,热度是真的,但独立第三方复现还没出来。解法:把它当上限看,别当基线,拿一条真实业务视频跑一遍再下结论。
坑 2:实时不等于便宜
现象:25 到 42 FPS 听着很流畅。根因:流式推理是持续占着显存,跟离线跑一次就完事完全是两种成本结构。解法:先算单位时间的 GPU 花销,再算 ROI,别被 FPS 这一个数字带跑。
坑 3:长时稳定是抑制,不是根治
现象:官方自己用的词就是抑制。根因:SRF 缓解误差累积,但流式生成天生带着这个风险,跑得越久概率越大。解法:长任务做分段重启,或者定时重置一次状态,别指望一口气跑一小时。
坑 4:空间视频现在还只是个彩蛋
现象:实时生成或实时编辑出来的视频,可以实时转成同步的左右眼立体视频,直接推到 VR 头显上看。根因:官方定位是探索方向,没有成熟工作流和配套工具链。解法:当彩蛋看,别给它排期。
坑 5:竞争对手还没落地,别押注单一厂商
现象:几乎同一时间,彭博社 9 月 7 日报道字节跳动正在开发基于 Seedance 的实时空间视频生成模型,面向直播、短剧、游戏和 Pico 等 VR 场景。根因:两边都还在早期,谁先跑通工程化不好说。解法:现在最划算的是把手跑熟、把流程沉淀下来,厂商怎么变你都不亏。
写在最后:视频不再是交付物,是一条你能插手的河
这两年视频模型的叙事一直是生成,比谁更像真的,比谁更长,比谁更快出片。Vidu S2 把叙事换成了操控。视频不再是一个交到你手里的文件,是一条一直在流的河,你随时能伸手进去改个方向。
而操控比生成难得多。生成只要最后一帧好看,操控要求每一帧都不能崩。所以这次发布真正值得关注的不是那几个跑分,是它把一个更难的问题摆上台面,并且发布当天就把入口开给了所有人。
入口再放一次:vidu.com/vidu-stream。花十分钟丢一条自己的素材进去,比看十篇解读都有用。
关注圈圈,持续带你玩转 AI 工具。


















暂无评论内容