排序

别再求人调模型了!Google新技能gemma-trainer:普通电脑8GB显存,一键训出专属AI
第一章 微调这事儿,普通人以前为啥够不着 你有没有过这种憋屈:用着别人的大模型,怎么调提示词都调不出“自己人”的味道。想让它说你们品牌的梗、按你们行业的黑话答、按你想要的格式出,它偏...
 7月30日 16:52

别再闭眼装 Skill 了:4 万个技能里 26.1% 带漏洞,NVIDIA 开源了个扫描器
.wb-article h1 { font-size:26px;font-weight:700;line-height:1.4;margin:0 0 18px;color:#1a1a1a } .wb-article h2 { font-size:21px;font-weight:700;line-height:1.5;margin:36px 0 14px;c...
10月11日 12:12
说实话我对更强模型早免疫了,直到Fable 5.1连干三天自己纠错
说实话我对更强模型早免疫了,直到Fable 5.1连干三天自己纠错 说实话,我对'更强模型'已经免疫了 之前 GPT-5.6、Claude Opus 5 一个个往外蹦,我的反应都是'哦,又强了'。测评榜上多涨几个点,...
9月2日 12:09
全球最大开源模型来了!Kimi K3 实测:换一个网址,老工具全接入,百万上下文塞整库
第一章 先说结论:2.8 万亿参数的开源核弹 2026 年 8 月,AI 圈最炸的不是新手机,是一个开源模型:Kimi K3。月之暗面 7 月 27 号把完整权重开源,上线 48 小时请求量直接打满集群,逼得官方暂...
8月4日 14:50
WASTE引擎炸场:2.78万亿参数Kimi K3,在64GB内存笔记本上跑起来了
第一章 2.78 万亿参数的模型,在一台笔记本上'跑'起来了 先说个听起来像吹牛的事:一个 2.78 万亿参数的大模型——月之暗面的 Kimi K3——整套完整权重,跑在了一台只有 64GB 内存的 MacBook Pr...
8月2日 08:51
刚发布就炸场!DeepSeek-V4-Flash上手:1M上下文+Agent能力,成本不到GPT-5一半
第一章 这玩意儿到底是啥?一句话说清 8月2号,DeepSeek 正式把 V4-Flash 的「稳定版」端上来了。别被名字里的 Flash 骗了——这可不是以前那种「轻量就等于阉割」的小模型。 它总参数 284B,每...
8月2日 11:14
还在给AI复读你的规矩?Prime Agent 开源爆火:一行命令装,越用越懂你,ARC-AGI-3超人类
第一章 一个能'自己变强'的AI编程Agent,来了 先说结论:这几天最炸的开源项目,是 Prime Intellect 甩出来的 Prime Agent。为什么值得你放下手里的活看两眼?就一句话——它是目前极少数'用一...
8月10日 09:02
别再手写 while 循环了:OpenAI Agents API 实测,四件脏活它全包,你只写业务
.wb-article h2 { font-size:21px;line-height:1.5;margin:38px 0 16px;padding-left:11px;border-left:4px solid #2b7fff } .wb-article p { margin:15px 0 } .wb-article code { background:#...
9月12日 12:25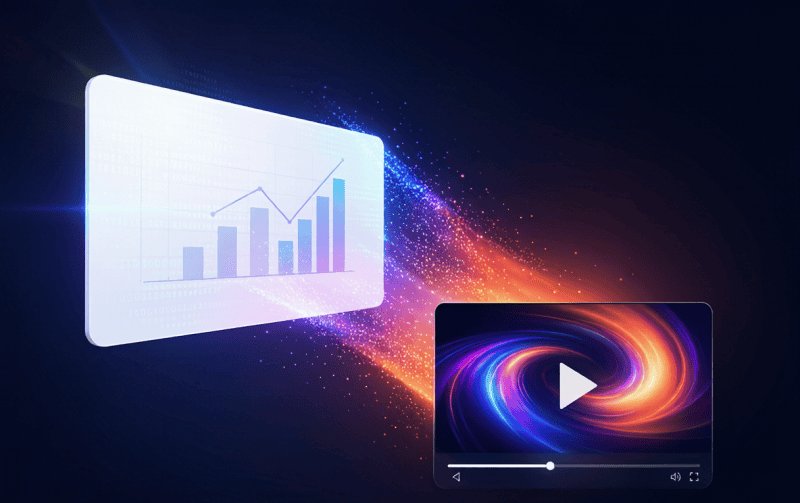
别再熬夜剪视频了!阿里Wan3.0公测:PPT/Word直接生30秒成片,0.3元/秒,万物皆可生视频
第一章 视频生成进入'文档纪元' 做视频最劝退的是什么?不是没创意,是剪。素材、配音、字幕、转场,一条一分钟的片子能熬你一下午。8月6日,阿里通义万相 Wan3.0 开启公测,直接把这道门槛铲平...
8月7日 09:22
上传一张图20秒变3D资产?群核Lux3D实测:成本7分钱,还能接Codex批量产
先搞清楚:Lux3D 和你用过的 AI 3D 到底差在哪 说实话,AI 3D 这赛道我早就免疫了。前两年 Tripo、Meshy 一波上来,个个都说'一句话出模型',结果呢?几何看着像,表面一转光就露馅,灰扑扑一层...
8月28日 12:10热门文章