




Agent 部署模型翻车 80 分钟?AWS 和 Hugging Face 塞给 Coding Agent 六个技能包,容器一次就选对
先说那个让人拍大腿的数字
说实话,我对 “AI 帮我部署模型” 这类内容已经免疫了。写个配置,起个端点,收工,有什么好讲的?
直到我看到一组数字:大约 80 分钟,4 次失败的端点尝试,最后换成 vLLM 才跑通。
这不是论坛吐槽,是 AWS 官方技术博客里的对照实验,Hugging Face 社区 2026 年 7 月 7 日的帖子给出了同样的记录。任务本身很简单:把 Qwen/Qwen3-0.6B 部署成 SageMaker 实时端点,把计划写进文件,并记录每一步动作。
上场的是 Kiro(Auto 或 Claude Fable 5)和 Claude Code(Opus 4.8)。
结果呢,两个 Agent 不约而同选了 TGI(Text Generation Inference)当服务容器。理由朴素得让人没法反驳:过去几年几乎所有部署教程都默认 TGI,模型记得最牢的就是它。
然后就翻车了:该 AWS 区域可用的 TGI 构建版本早于 Qwen3 架构,端点健康检查直接不过。最要命的是 Agent 压根没怀疑自己的选型,它开始自救,升 TGI 版本,重新部署,又失败,每失败一次 GPU 计费时长都在烧。
六个技能包里装了什么

2026 年 9 月 18 日,AWS 和 Hugging Face 联合放出了六个开源 Agent Skills。仓库就在 GitHub 的 huggingface/skills,AWS 博客里给了一个固定 commit:f3186efbbc322121eb5d0f31e8a1d669ee961159。署名是 Hugging Face 的 Dario Salvati、Álvaro Bartolomé,加上 AWS 解决方案架构师 Qiong Zhang 和 Sanhita Sarkar。
形态朴素得有点意外。所谓 Skill 就是 Markdown 文件,遵循开放的 agent skills 标准:一个文件夹,一份 SKILL.md,里面有一段 description,Agent 按需读取,读完再决定要不要加载后面的具体指令。多数技能包还附带了辅助 Python 脚本。
技术栈也很克制,只用 Python 加 AWS CLI,macOS、Linux、Windows 通吃。已经验证能搭配的 Agent 是 Kiro 和 Claude Code。如果你已经在用 Codex 的 Agent 技能,这套东西的心智模型对你来说完全是同一套。
默认产出是单个 ml.g5.xlarge 实时推理端点,账单 1.408 美元/小时/实例,并且默认自动挂上弹性伸缩(1 到 4 个实例)和三个 CloudWatch 告警。除了实时推理,还支持这些形态:
- 实时推理,可以缩容到零
- Serverless 推理
- 异步推理
- 批量转换
- Amazon Bedrock 自定义模型导入
1.408 美元/小时看着不多,但别忘了默认挂了弹性伸缩,最多能拉到 4 个实例。这就是为什么前面那 80 分钟的试错格外肉疼:你烧的不是一次部署的钱,是四次失败加一次重试、还带着自动扩容的钱。
凭记忆选,还是查完再选?差别就在这一步
装上这六个技能包之后,同一个 Qwen3-0.6B 任务,Agent 在动手创建任何资源之前,就选对了 vLLM。
注意这个 “之前”。这才是全部关键。
没有技能的 Agent 不是不会修,它会修,而且修得很勤快。真正的问题是,它把 “我记忆里的默认答案” 当成了前提,而前提这东西是没人会去质疑的。TGI 就是 Coding Agent 肌肉记忆里的老答案,它在训练数据里见过太多次,多到压根想不起来要先查一下这个模型架构是哪年出来的。
技能包做的事说白了就一件:在 Agent 开始写代码之前,先把它按在椅子上,把当前可用的容器版本和模型架构兼容性查一遍。
# Agent 拿到的不是 "用 TGI",而是一段前置检查
# 1. 确认模型架构的发布时间
# 2. 查询当前区域可用的容器镜像版本
# 3. 比对两者,不匹配就直接切 vLLM
那 80 分钟的账,就是这么省下来的。一次前置校验,顶掉后面所有试错。
不报错的那种错,才是最贵的
如果只有上面那个案例,我大概会觉得这只是运气问题。真正让我后背发凉的是第二个测试。
AWS 让 Agent 去部署一个新发布的多模态 MoE 扩散模型。无引导的 Agent 干了一件看起来很专业的事:它先确认了模型存在。
然后,它写出来的部署脚本仍然基于 TGI。一个文本生成服务器。
这个架构根本没有对应的 TGI 后端。但重点是:它不会报错。脚本能写完整,格式挑不出毛病,代码评审也大概率能过。只有端点真的起不来的时候,问题才暴露。
这才是 Agent 犯错最阴的地方。编译期错误是礼物,运行期错误是成本。而一份 “看起来对” 的部署脚本,把成本推迟到了最贵的时刻才结算。
三个坑:README 里都不会写
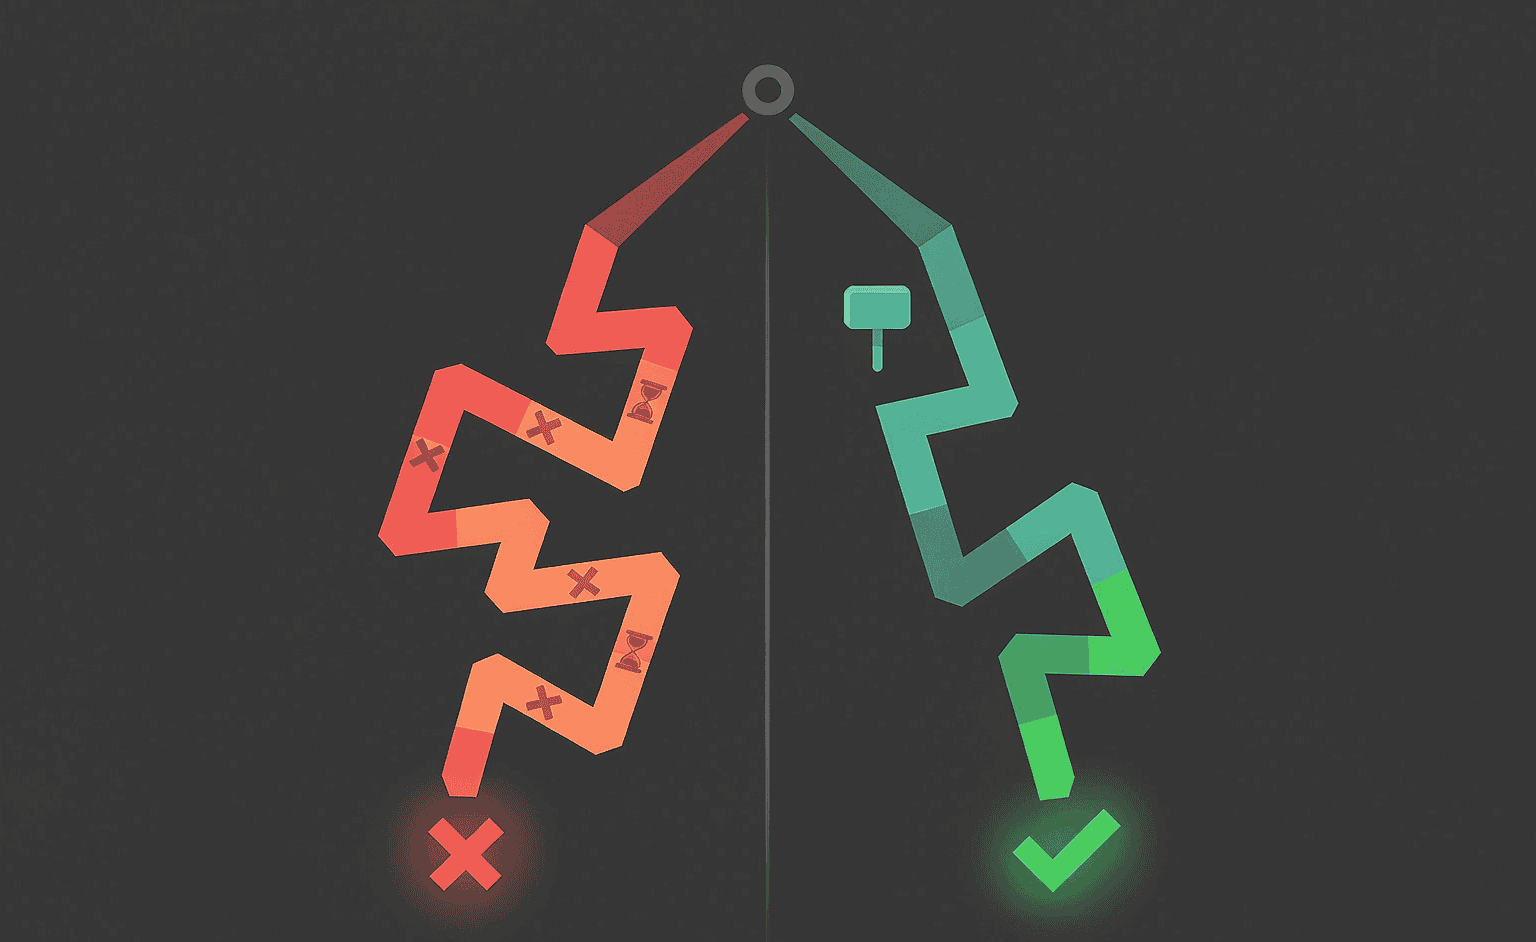
坑 1:端点健康检查一直红
现象 → 端点创建成功,健康检查却一直不过。根因 → 该区域可用的 TGI 构建版本早于 Qwen3 架构,压根不支持。解法 → 换 vLLM,不是改配置。Agent 最容易在这里钻牛角尖,因为它默认自己写错了,而不是默认自己选错了。
坑 2:反复重试,就是不换方案
现象 → 升 TGI 版本、重新部署、再失败,一口气循环四次。根因 → Agent 的流程里只有 “修 bug”,没有 “重新选型” 这一格。解法 → 用 Skill 把选型变成强制前置动作,写死在动手建资源之前。
坑 3:脚本没报错,端点却起不来
现象 → 多模态 MoE 扩散模型的部署脚本基于 TGI 写完了,语法和参数都正常。根因 → TGI 是文本生成服务器,这个架构就没有对应后端。解法 → 先确认模型架构类型,再匹配容器,顺序不能反。
上手:安装就一行命令
装这六个技能包没什么仪式感,本质就是往 Agent 能读到的 skills 目录里放文件夹。以 Claude Code 为例:
# 把技能包放进 Agent 的 skills 目录
git clone https://github.com/huggingface/skills.git ~/.claude/skills/huggingface-aws

# 想锁死行为,就切到 AWS 博客锁定的那个 commit
git checkout f3186efbbc322121eb5d0f31e8a1d669ee961159
放好之后不用手动调用。Agent 读到 SKILL.md 里的 description,自己判断这次任务要不要加载。你要做的只是正常下指令:
# 直接说人话就行
把 Qwen/Qwen3-0.6B 部署成 SageMaker 实时端点,成本别超预算

# 换形态也一样
用 Serverless 推理跑一下,流量低的时候能缩到零
环境依赖只有 Python 和 AWS CLI,先把 aws configure 走通,剩下的交给它。
Skill 是 Agent 的岗位手册
这件事给我的启发,比六个技能包本身大得多。
我们太习惯把 Agent 的错误归因于 “推理能力不够”。但这次的案例里,Agent 推理得挺好:确认了模型存在,写出了完整脚本,失败了还会自我修正。它缺的不是智商,是在岗培训。
一个刚入职的工程师,你不会指望他凭学校里学的那套直接上手干活。你会先给他一份岗位 SOP:哪些必须先查,哪些不能想当然,前人踩过什么坑。Skill 就是给 Agent 写 SOP 的载体,而且它比提示词强的地方在于按需加载,用不上的时候一点上下文都不占。
再往远看一步,这跟 MCP 协议 解决的是同一个问题的两面:MCP 给 Agent 接上工具,Skill 教 Agent 把工具用对。工具接得再多,选型还是错的,那接得越多烧得越快。
所以往后判断一个 Coding Agent 靠不靠谱,别只看它能不能写出代码,要看它的默认记忆有多久没更新了。
写在最后
回到开头那个数字。80 分钟,4 次失败的端点尝试,全花在了一个本可以在动手之前查清楚的问题上。
Agent 不会自己更新默认记忆,这事得你替它做。训练数据里那个 “大家都用 TGI” 的世界还会存在很久,而模型架构每个月都在往前跑,这个时间差只会越拉越大。
下次让 Agent 碰生产资源之前,先给它一份岗位手册,再让它动手。
关注圈圈,持续带你玩转 AI 工具。













暂无评论内容